이번 글에서는 카프카 컨슈머가 데이터를 가져오고 처리하는 공통 과정을 살펴본 뒤, 오토 커밋과 AckMode.BATCH가 커밋을 다루는 방식이 어떻게 다른지 비교해 보겠습니다.
이 글은 kafka-clients 3.8.1을 기준으로 작성했습니다.
1. KafkaContainer 내부 메인 루프
스프링 카프카가 실행되면 KafkaMessageListenerContainer가 동작하면서 컨슈머 스레드가 무한 루프를 돌며 pollAndInvoke() 메서드를 실행합니다.
// KafkaMessageListenerContainer 내부 메인 루프
protected void pollAndInvoke() {
    doProcessCommits();           // ① (스프링 카프카 관리 시) 커밋 처리
    doPoll();                     // ② 브로커로부터 레코드 가져오기 (poll)
    invokeIfHaveRecords(records); // ③ 비즈니스 로직(@KafkaListener) 실행
}
공통 동작 ①: doPoll()
doPoll()은 결국 this.consumer.poll()을 호출합니다.

group.protocol이 classic(기본값)이면 실제 구현체로 LegacyKafkaConsumer의 poll()이 실행됩니다. 이 poll()은 내부에서 두 단계를 순서대로 거칩니다.
updateAssignmentMetadataIfNeeded(timer); // 메타데이터 업데이트 (※ 오토 커밋은 여기서 동작!)
pollForFetches(timer);                   // 실제 데이터 패치 및 position 이동
여기서 데이터를 가져오는 핵심 로직인 pollForFetches(timer) 내부를 열어보면 세 단계로 동작합니다.
fetcher.collectFetch();                                         // 1. 버퍼에서 레코드 꺼내기 & position 이동
sendFetches();                                                  // 2. 다음 Fetch 요청 준비
client.poll(pollTimer, () -> !fetcher.hasAvailableFetches());   // 3. 실제 네트워크 I/O 수행
fetcher.collectFetch()
컨슈머가 다음에 읽어야 할 오프셋 위치(position)를 이동시킵니다.
if (nextInLineFetch.nextFetchOffset() > position.offset) {
    subscriptions.position(tp, nextPosition); // 레코드를 꺼낸 만큼 position 전진!
}
sendFetches()
브로커별로 FetchRequest를 만들어서 보낼 큐에 넣고, 응답에 콜백을 등록해둡니다.
- 요청 만들기 : 지금 fetch할 수 있는 파티션들을 리더 브로커별로 묶어 "이 파티션은 이 오프셋부터 주세요"라는 요청을 만듭니다. 이미 요청이 나가 있거나 버퍼에 데이터가 남아 있는 파티션은 제외합니다.
- 큐에 넣기 : 만든 요청을 ConsumerNetworkClient의 unsent 큐에 넣습니다. 아직 전송은 하지 않습니다.
- 콜백 등록 : 응답이 오면 handleFetchSuccess로 fetchBuffer에 적재하고, 실패하면 handleFetchFailure로 처리하도록 걸어둡니다.
client.poll()
여기서 실제 네트워크 I/O가 일어납니다.
trySend(timer.currentTimeMs());
client.poll(pollTimeout, timer.currentTimeMs());
trySend()는 unsent 큐에 쌓인 요청을 브로커별 전송 큐를 준비합니다.
client.poll()은 NetworkClient 내부에서 Java NIO의 Selector로 실제 읽기·쓰기를 논블로킹으로 처리합니다. 이렇게 도착한 응답은 콜백을 통해 fetchBuffer에 쌓이고, 다음 collectFetch()에서 꺼내집니다.
공통 동작 ②: invokeIfHaveRecords() — 동기식 리스너 실행
doPoll()을 통해 레코드 묶음을 가져왔다면, 이제 우리가 작성한 리스너에 데이터를 넘겨줄 차례입니다.
Iterator<ConsumerRecord<K, V>> iterator = records.iterator(); // poll로 받은 전체 레코드

while (iterator.hasNext()) {
    ...
    doInvokeRecordListener(cRecord, iterator); // 리스너가 완전히 끝나야 다음 루프로 진행
    ...
}
이 코드는 단일 스레드에서 완전한 동기식(Synchronous)으로 동작합니다. 만약 poll()로 500개의 레코드를 가져왔다면, while 문을 500번 돌면서 리스너 메서드를 하나씩 실행합니다. 500개가 모두 처리되어야만 비로소 while 문이 끝나고 한 바퀴(pollAndInvoke)가 종료됩니다.
정리해보면 KafkaMessageListenerContainer가 반복적으로 동작하는 흐름은 아래와 같습니다.
- 컨테이너는 한 스레드에서 커밋 처리 → poll → 리스너 호출을 반복합니다.
- poll() 안에서 레코드가 반환되면 그만큼 position이 전진합니다.
커밋이란 결국 이 position을 브로커에 저장하는 일입니다. 오토 커밋과 BATCH의 커밋방식 차이에 대해 알아봅시다.
2-1. 오토 커밋(enable.auto.commit=true)은 어떻게 동작할까?
오토 커밋의 동작 규칙은 다음과 같습니다.
- poll()을 호출할 때마다 auto.commit.interval.ms(기본 5000ms)가 지났는지 확인한다.
- 시간이 지났다면, 직전 poll()로 받아간 레코드들의 다음 오프셋(현재 position)을 비동기(commitAsync)로 커밋한다. (그 외 리밸런싱 직전이나 close() 시점에도 커밋한다.)
아까 살펴본 공통 동작 1 - doPoll()의 첫 번째 줄, updateAssignmentMetadataIfNeeded(timer) 내부를 따라가 보면 coordinator.poll()을 거쳐 아래 메서드가 실행됩니다.
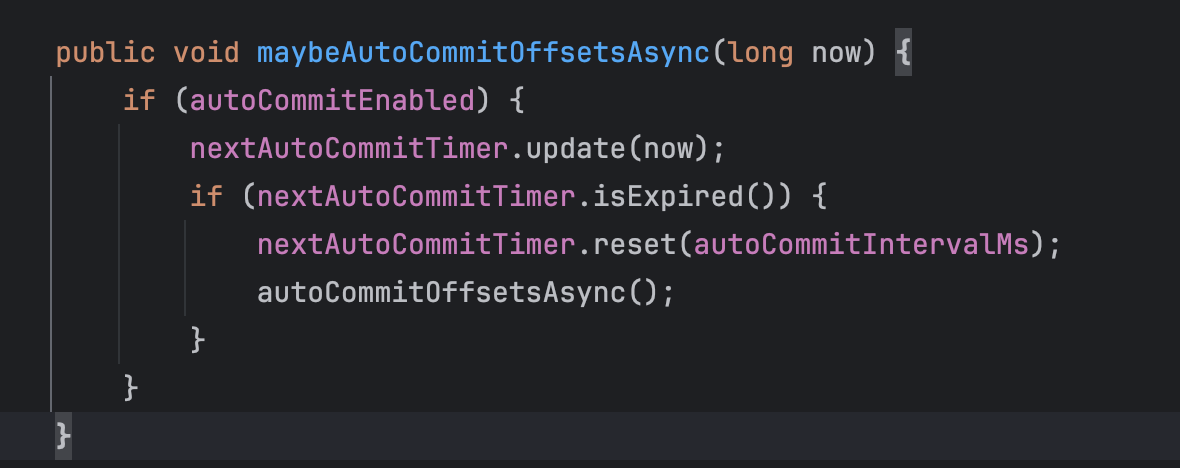
여기서 확인할 수 있듯이 특정 시간이 지났다면 타이머를 리셋한 뒤 비동기로 커밋합니다.
2-2. AckMode.BATCH는 어떻게 동작할까?
스프링 카프카의 기본 전략인 AckMode.BATCH의 경우 poll 로 받아온 레코드를 다 처리한 후 한번에 커밋합니다. 그렇다면 정확히 언제 커밋이 일어날까요? 다시 컨테이너의 메인 루프인 pollAndInvoke()의 전체 호출 과정을 확인해보겠습니다.
pollAndInvoke()
├─ doProcessCommits()                       ③ 다음 바퀴로 돌아왔을 때 여기서 커밋!
├─ doPoll()                                 ① 레코드 묶음 받기 (position 이동)
└─ invokeIfHaveRecords(records)             ② 리스너 메서드가 한개씩 처리
①번에서 레코드를 가져오고, ②번에서 while 문을 돌며 모든 레코드를 동기식으로 처리한 뒤, 루프의 다음 바퀴 첫 시작점인 ③번 doProcessCommits()로 들어갑니다. 이 내부의 processCommits()에서 AckMode별 분기가 일어납니다.
private void processCommits() {
    this.count += this.acks.size();
    handleAcks();
    if (this.isCountAck) {
        countAcks();
    }
    else if (this.isTimeAck) {
        timedAcks();
    }
    else if (!this.isManualImmediateAck) {
        // AckMode.BATCH는 여기로 진입합니다!
        commitIfNecessary(); // 내부에서 commitSync() 호출!
        this.count = 0;
    }
}
BATCH는 COUNT도, TIME도, MANUAL_IMMEDIATE도 아니므로 세 번째 분기인 commitIfNecessary()로 들어가고, 여기서 쌓여 있던 오프셋을 commitSync()로 동기 커밋합니다.
BATCH는 "다 처리했는지" 어떻게 알까?
자연스럽게 이런 의문이 듭니다. BATCH 모드는 poll로 받은 레코드가 전부 처리되었는지 어떻게 확인하고 커밋하는 걸까요?
답은 따로 확인하지 않는다입니다. 앞서본 pollAndInvoke() 의 동기식 루프 구조 덕분입니다. poll(), 리스너 실행, 커밋이 모두 같은 스레드에서 순서대로 실행됩니다. 즉, invokeIfHaveRecords()에서 500개의 레코드를 무사히 다 처리해야만 메서드가 리턴되어 다음 바퀴의 doProcessCommits() 줄에 도착할 수 있습니다.
호출 스택으로 보면 다음과 같습니다.
pollAndInvoke()
├─ doProcessCommits()                       ③ 다음 바퀴로 돌아왔을 때 여기서 커밋!
├─ doPoll()                                 ① 레코드 묶음 받기 (position 이동)
└─ invokeIfHaveRecords(records)             ② 리스너 메서드가 한개씩 처리
① 레코드를 받고, ② 전부 처리한 뒤 루프를 한 바퀴 돌아, ③ 다음 pollAndInvoke()의 맨 앞에서 커밋합니다. 코드가 커밋 줄에 도착했다면 직전 poll의 레코드 처리는 이미 끝나 있는 것입니다.
마치며: 결국 어떤 커밋 모드를 선택해야 할까?
사실 이번 과제에서는 요구사항에 맞춰 수동 커밋 방식인 AckMode.MANUAL_IMMEDIATE를 사용했습니다. 하지만 내부 코드를 직접 뜯어보며 비교해 보니, 오토 커밋이든 BATCH든 MANUAL_IMMEDIATE든 단일 스레드 동기식 루프 구조 덕분에 아직 처리되지 않은 레코드가 먼저 커밋될 일은 없다는 공통점을 확인할 수 있었습니다.
결국 세 방식 모두 장애가 발생했을 때의 핵심 리스크는 '커밋 타이밍 차이로 인한 재처리(중복) 범위가 얼마나 넓은가'에 달려 있습니다.
- 오토 커밋: poll() 시점에 인터벌(기본 5초)이 지났는지만 보고 비동기로 커밋하므로, 커밋 주기가 길어질수록 장애 시 재처리해야 할 범위가 가장 넓어질 수 있습니다.
- MANUAL_IMMEDIATE: 원하는 시점에 레코드 단위로 즉시 커밋할 수 있어 재처리 범위를 가장 좁게 가져갈 수 있지만, 매번 브로커와 통신해야 하므로 네트워크 비용이 큽니다.
- BATCH: 한 번의 poll()로 가져온 묶음을 모두 처리한 뒤 루프가 도는 흐름에 맞춰 한 번만 커밋하므로, 안전성과 성능 사이의 균형이 가장 잘 맞습니다.
직접 내부 동작을 확인해 보니 왜 스프링 카프카가 AckMode.BATCH를 기본값으로 채택했는지 납득이 갔습니다. 컨슈머의 메인 루프와 가장 자연스럽게 맞물려 돌아가는 구조 입니다. 앞으로도 세밀한 커밋 제어가 필요한 특별한 요구사항이 없다면, 가장 자연스러운 기본값인 BATCH 모드를 주로 사용하게 될 것 같습니다.
'기타 주제' 카테고리의 다른 글
| PG 연동 : 10초 안에 상태를 결정해야 하는 경우 (0) | 2026.10.23 |
|---|---|
| 상품 목록 조회 쿼리를 개선해보자 (0) | 2026.10.14 |
| 낙관적 락과 비관적 락, 상황에 따라 무엇을 고를까 (0) | 2026.10.09 |
| 모호한 요청을 받았을 때 먼저 던지는 질문 (0) | 2026.09.10 |
| 안정 해시(Consistent Hashing) (0) | 2025.08.17 |


